Was sind Edge und Edge Computing?
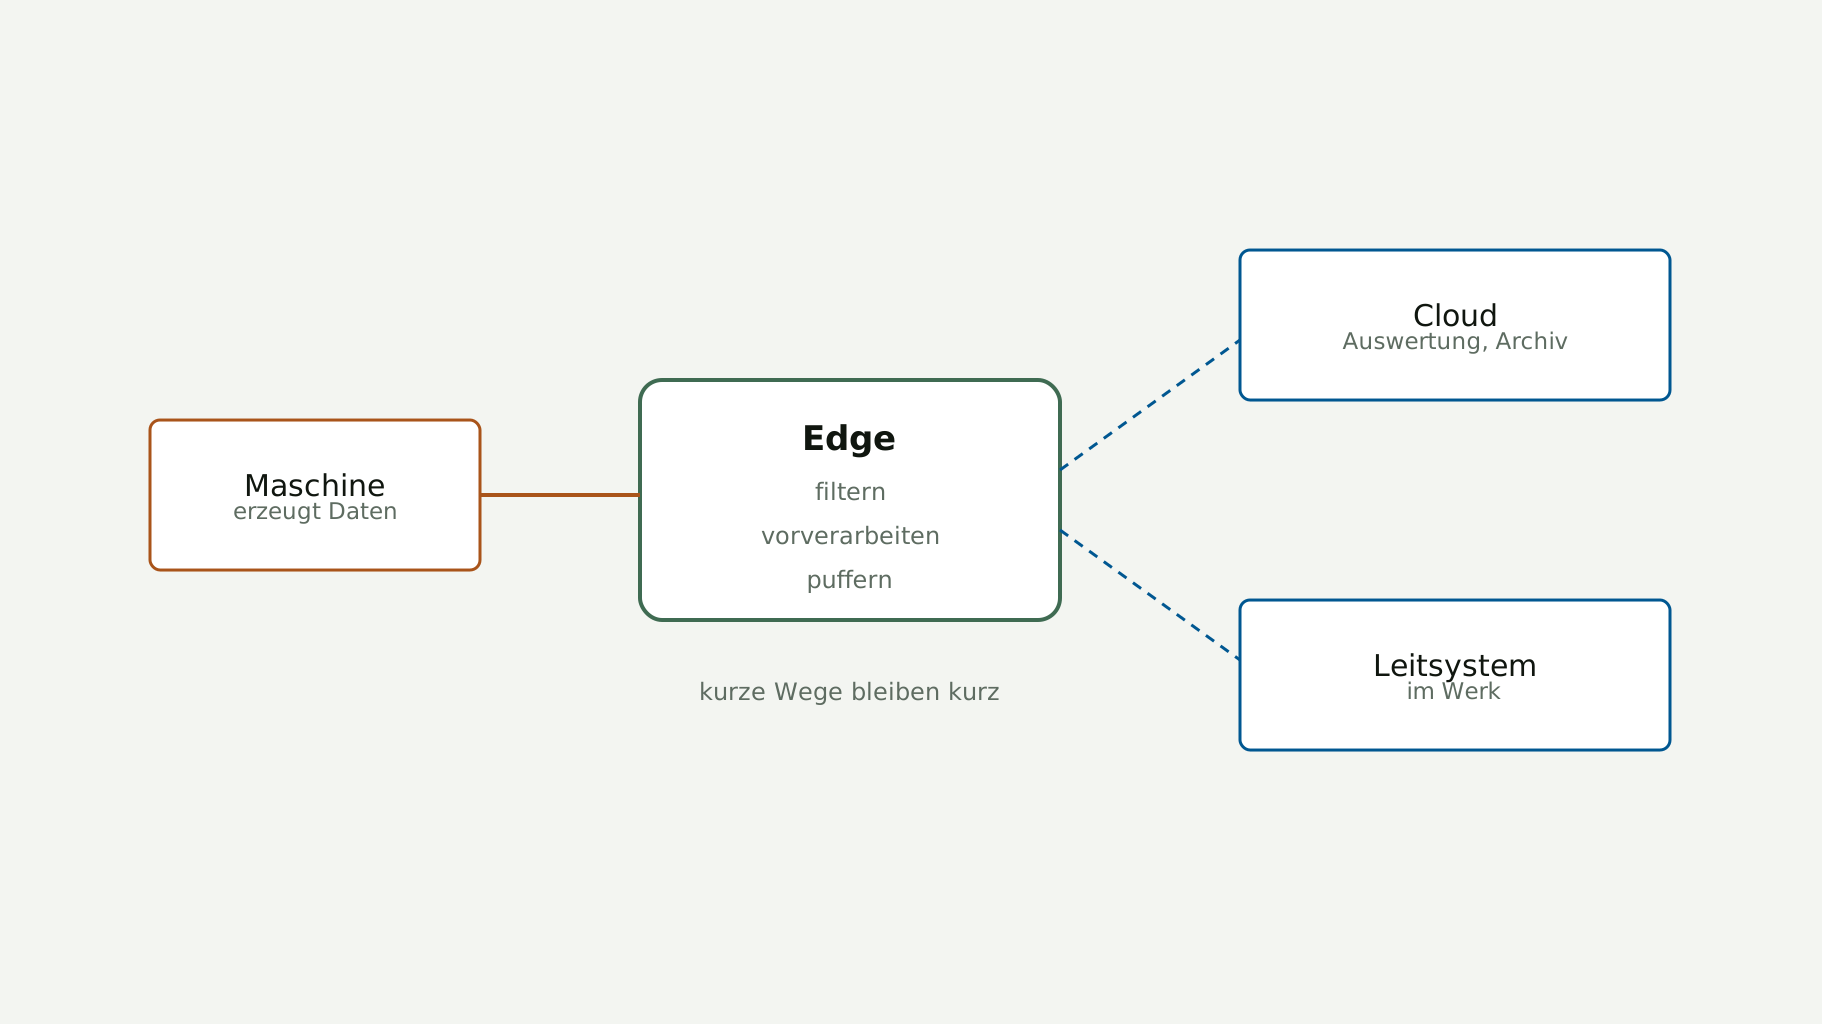
Edge heißt: Daten dort verarbeiten, wo sie entstehen — am Rand des Netzes, an der Maschine, statt in einem entfernten Rechenzentrum. Das senkt Latenz und Bandbreitenbedarf und hält die Reaktion im Werk. Nach oben geht dann nicht mehr jede Messung, sondern das Ergebnis.
Definition: Edge und Edge Computing
Edge bezeichnet die Entstehung und Verarbeitung von Daten in der Nähe ihres Entstehungsorts — der Rand des Netzes, an dem lokale Netze auf größere treffen. Edge Computing verlagert Verarbeitung und Analyse genau dorthin, statt sie zentral in Rechenzentren oder in der Cloud zu erledigen.
Die Bedeutung des Ansatzes ist in den letzten Jahren gewachsen, weil zwei Anforderungen zugenommen haben: Verarbeitung in Echtzeit und niedrige Latenzzeiten.
Wie Edge Computing arbeitet
Statt jede Messung an ein entferntes Rechenzentrum zu schicken, laufen Verarbeitung und Analyse lokal, in der Nähe der Quelle — am Sensor, an der Steuerung, auf einem Gerät im Schaltschrank. Weil die Daten dafür keine weiten Wege zurücklegen, sinkt die Latenz, und Reaktionen auf Ereignisse sind sofort möglich.
Die verarbeiteten Informationen gehen anschließend weiter, je nach Bedarf — an zentrale Server oder andere Systeme, wo umfassendere Analysen und die Archivierung stattfinden. Diesen Weg nach oben übernimmt üblicherweise eine Middleware.
Womit Edge-Geräte sprechen
| Protokoll | Art | Wofür es am Rand taugt |
|---|---|---|
| MQTT | Nachrichtenorientiert, Veröffentlichen/Abonnieren | Ressourcenschonend und damit passend für Geräte mit wenig Leistung. Geräte senden zu einem Thema, interessierte Empfänger hören mit. |
| REST | Architekturstil über HTTP | Weit verbreitet in Webanwendungen und Cloud-Diensten; Edge-Geräte können Daten über die bekannten HTTP-Methoden abgeben und abrufen. |
Wo es sich auszahlt
Der Nutzen ist nicht auf die Fertigung beschränkt. In der Industrieautomation optimiert Edge Computing Prozesse und verringert ungeplante Ausfallzeiten; in der Automobilindustrie trägt es zur Sicherheit autonomer Fahrzeuge bei; im IoT-Bereich macht es die Verarbeitung von Gerätedaten effizient; im Gesundheitswesen ermöglicht es Überwachung in Echtzeit; im Einzelhandel Auswertungen zum Kundenverhalten; in der Öl- und Gasindustrie steigert es die Effizienz an entlegenen Standorten.
Die Gemeinsamkeit: überall dort, wo eine Antwort schnell da sein muss und die Leitung nach außen entweder schmal, teuer oder unzuverlässig ist.
Edge oder zentrale Serverstruktur
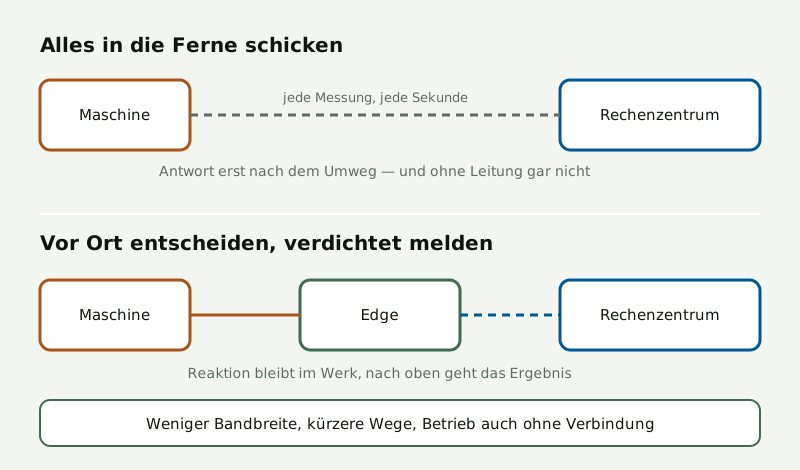
Oben geht jede Messung den weiten Weg. Unten bleibt die Reaktion im Werk, und nach oben geht das Ergebnis.
In der herkömmlichen Serverstruktur läuft die Verarbeitung in zentralen Rechenzentren oder Cloud-Servern — oft weit weg von den Quellen. Beim Edge Computing passiert sie nahe an der Entstehung. Daraus folgen drei Unterschiede, die im Betrieb zählen: sehr niedrige Latenz, weniger Daten im Netz und eine Struktur, die sich leichter erweitern lässt, ohne die zentralen Ressourcen anzufassen.
Edge ersetzt die Zentrale nicht. Auswertung über Standorte hinweg, Archiv und Modellbildung bleiben dort sinnvoll. Die Frage ist nicht „Edge oder Cloud“, sondern welche Entscheidung wo fallen muss — und welche Daten dafür überhaupt den Weg antreten müssen.
Was Edge für die Sicherheit bedeutet
- Weniger Übertragung. Was lokal verarbeitet wird, muss nicht über unsichere Netze wandern — das verringert das Risiko unterwegs.
- Schnellere Reaktion. Niedrige Latenz hilft auch beim Erkennen und Abwehren von Vorfällen.
- Entlastetes Netz. Lokale Verarbeitung schont Bandbreite und schützt vor Überlast.
- Abgegrenzte Zonen. Edge-Geräte lassen sich als in sich geschlossene Sicherheitszonen betreiben; ein Angreifer kommt von dort nicht ohne Weiteres ins ganze Netz.
- Redundanz. Fällt ein Gerät aus, kann ein anderes die Aufgabe übernehmen.
Umsetzung mit connubes
connubes läuft plattformunabhängig — unter Windows, in Docker oder in Kubernetes — und damit auch auf einem Gerät im Werk statt nur im Rechenzentrum. Die Verbindungen sind dieselben wie überall: an der Anlage per OPC UA oder direkt an der Steuerung, nach oben per MQTT, REST oder in die Datenbank.
Begriffe kurz erklärt
- Latenz
- Die Zeit zwischen Ereignis und Reaktion. Sie wächst mit jedem Netzabschnitt, den die Daten zurücklegen.
- Edge Device
- Ein Gerät am Rand des Netzes, das Daten aufnimmt, verarbeitet und weitergibt.
- Container
- Eine gekapselte Laufzeitumgebung, etwa mit Docker. Sie macht es möglich, dieselbe Anwendung auf verschiedenen Geräten gleich zu betreiben.
- Fog Computing
- Eine Zwischenschicht zwischen Edge und Cloud; sie bündelt mehrere Edge-Geräte, bevor es weiter nach oben geht.
Häufige Fragen
Was ist Edge Computing?
Die Verlagerung von Datenverarbeitung und Analyse an den Ort, an dem die Daten entstehen, statt in ein zentrales Rechenzentrum oder die Cloud.
Welchen Vorteil bringt das?
Niedrigere Latenz, weniger Last im Netz und eine Struktur, die sich erweitern lässt, ohne die zentralen Ressourcen anzufassen. Die Reaktion bleibt dort, wo sie gebraucht wird.
Brauche ich dann keine Cloud mehr?
Doch. Auswertung über Standorte hinweg, Archiv und Modellbildung bleiben zentral sinnvoll. Edge entscheidet nur, was vor Ort passiert und was überhaupt hochgeschickt wird.
Ist Edge sicherer?
In mehreren Punkten ja: weniger Daten unterwegs, abgegrenzte Sicherheitszonen, schnellere Reaktion auf Vorfälle und die Möglichkeit, Geräte redundant zu betreiben.
Läuft connubes am Edge?
Ja — plattformunabhängig unter Windows, in Docker oder in Kubernetes, also auch auf einem Gerät im Werk.